Building a compiler for Danish – or using a LLM as a catalyst for acquiring a new skill
The other day a colleague and I talked about LLMs – again. I don’t quite remember where we started. However, we ended in a discussion on using LLM technologies as assistants that evaluate what you create versus using them for creating stuff, where you’re the evaluator, where you’re their assistant, so to speak. The specific scenario was writing correct prose, fiction or non-fiction. None of us is very fluent in gramma, syntax, and spelling human language, but very well versed in writing computer code. My colleague then suggested that if their teacher in elementary school had been as unforgiving and terse as a computer language compiler, they would’ve had no problem in writing perfect prose. We then had this proto-prompt: “Dear LLM, create a program that validates the grammar, syntax, and spelling of a Danish or English text as if it was a compiler and outputs error messages as a compiler would without any suggestions of how to correct the error.” Our idea was that this would force the user to learn the grammar, syntax and spelling instead of just asking an “AI” to create a perfect text. My last chat message to them that day was: A fun project for a cold and dark winter evening.
But the seed had been planted, and the brain wouldn’t let it go. I mean, how hard could it be? Alas, I had to start from scratch, knowing little about grammar and syntax and almost nothing about NLP? But could I build such a compiler with the assistance of some LLM?
Well, yesterday morning, I couldn’t resist the urge and fired up myPi Coding Harness in an empty folder, intending to do a greenfield proof of concept. I started with a very fun and interesting “grill me” session that took at least a couple of hours and ended with a very elaborate plan:
>: wc -l CONTEXT.md
     214 CONTEXT.md
>: wc -l plans/*
      18 plans/roadmap.md
     136 plans/vertical-slice-plan.md
     154 total
>: wc -l docs/adr/*
      15 docs/adr/0001-learning-first-compiler-diagnostics.md
      15 docs/adr/0002-deterministic-diagnostic-testing.md
      18 docs/adr/0003-wolfram-first-personal-prototype.md
      48 total
Some of the relevant implementation decisions were to use theWolfram Language, focus on Danish, and the internals should not be like a compiler, but the output should feel like working with a compiler. This last decision took some rounds, as the LLM gravitated towards a Rust implementation with internals modeled after a real compiler, which unnecessarily would have made this a much harder problem. Python was, given its strengths in both ML, LLM, and NPL, of course, also one of the suggestions. However, it was rejected first by the LLM, as it didn’t fit well with the “internal compiler model” and then by me, as I’ve yet to have a pleasant experience with Python. So, we abandoned that. Also abandoned were JavaScript/Node and my suggestions Swift, Clojure, and Go.
We then started to implement a first version, and it went well – until it didn’t. At the end of the day – literally – we did have a tiny toy proof of concept, but a lot of the internals were hard-coded. Word lists, comma rules, etc. Spelling, though, was handled bySpellingCorrectionList[word, Language -> ”Danish”]from Wolfram Language but that also didn’t quite work. Checking of tense was handled by a local LLM running under LlamaBarn and llama.cpp, but also not quite in a working and robust state.
The LLM had written 568 lines of Wolfram code
      44 ./tools/build-cor-resources.wls
     524 ./src/danskc.wls
     568 total
And the program is not all bad. Look at this mock-up text with some errors and problems
>: cat test.txt|fmt
Jeg inviterer hermed til et møde hvor jeg ønsker at drøfte de seneste
udvikling. Jeg mener ikke, at den nyværende politik er dækkende og
jeg vil åbne muligheden for et revision af denne. Umiddlebart
forestiller jeg mig, at vi mødes i udvalget og inviterer
informationssikkerhedschefen og vores DPO. Det bedste ville gøg
være hvis vi ikek inviterer ledelsen. Jeg tror et god ide ville
være en på forhånd udarbejdet dagsorden hvor, vi hver især indskriver
vores indlæg og den nødvendige tid.
Running the Danish compiler danskc on it gives
>: bin/danskc test-wrapped.txt
test-wrapped.txt:1:32: error[DK-COMMA-SUBORDINATE]: der mangler et komma før ledsætningen
test-wrapped.txt:2:35: error[DK-SPELLING]: "nyværende" er stavet forkert
test-wrapped.txt:2:56: error[DK-COMMA-MAIN]: der mangler komma mellem helsætninger
test-wrapped.txt:3:29: error[DK-GENDER]: kendeordets køn stemmer ikke med navneordet: "et" og "revision"
test-wrapped.txt:6:14: error[DK-SPELLING]: "ikek" er stavet forkert
test-wrapped.txt:8:7: error[DK-COMMA-MAIN]: der mangler komma mellem helsætninger
The output does look like coming from a compiler, but it clearly does not identify all problems. In the process I did push the agent to improve, but it became clear that the underlining program model was not going to work without a lot of work and improved understanding by me of the multiple domains.
The morning after, i.e., today, where I write this, I started from scratch and tried to create an LLM-only solution, which in less than an hour was an order of magnitude better, but slower and also to get really good results, it had to rely on commercial API endpoints which means a loss of data security and money.
I did implement two skills for my Pi coding agent using this model: one that produces clear text output like above and one that creates an HTML page with the identified errors. Both the clear text and the HTML output look precisely as I wanted, but the content, i.e., the important stuff, is not quite there – as it often is the case with these technologies.
Then, because it became an interesting subject, I started to investigate some of the available online resources for the Danish language that had come up in the process. The more I found, the more I looked, and the more interesting it became.
Now, I’m at a place where I find learning the Danish grammar and syntax so interesting that I won’t let a computer do it for me. This is a task I want to do by myself because it’s fun and allows me to learn new stuff and acquire a new skill. So, bye bye computer compiler for Danish, hello Retskrivningsordbogen and welcome to training a new skill.
Lessons Learned
In the very first pitch of this project, I introduced the compiler metaphor. This metaphor resulted in the planning process working towards a far too rigorous implementation with very controlled and deterministic internals just like a real compiler, where what I actually wanted was more something that to the user feels like working with a compiler. So, when pitching a project, remember that everything is taken very literally and LLMs are not very good at understanding metaphors, see e.g.: https://cst.ku.dk/english/projects/metallm.
The planning process also gravitated towards enterprise solutions minded for a team of developers, whereas this project is just a one-man band trying out an idea. Again, be very specific in the initial framing of the task.
The grill-me process was fun, pleasant, and invaluable in getting from an idea into something that resembled a real project. In this process I also learned about Architecture Decision Records (ADR), which I hadn’t come across before.
One thing that struck me here at the end of this writing process is that I’m in this business because I find programming fun. So why delegate that to the computer?
Oh well, a few more lessons learned
- That Retskrivningsordbogen is a great online resource!
- How to create skills for Pi
- That Claude is a beast that I can’t control and don’t want on my computer. It’s now gone.
- That
SpellingCorrectionList[#, Language -> "Danish"] & /@TextWords[tekst]could be fun to play around with. - That grammar and syntax can be interesting to me. Actually, this is no surprise, as I have a saying: anything that I dive into becomes interesting if I just dive deep enough…
Ever since trying ChatGPT for the first time, the technology has kept surprising me with new areas of functionality. From the first “dialogue” to identifying objects in pictures, converting a graph drawn on a whiteboard into a JSON representation, to transforming pictures of text and audio recordings of voices into computable text,creating working computer programs, learning stuff and a rather poetic and moving story. Still, almost in every instance, all my experiments have not successfully moved beyond the toy example. I personally have not seen the LLM technology work in a true enterprise setting where maintenance, long time support and development, robustness, etc. are more important than the speed with which new fancy things can be created. Especially the software projects I have created are almost all unmaintainable one-shot projects. Now, I know that I'm writing myopic with blinders, and that responsible people around me actually ship good solutions and that I nowadays am well removed from software development. Anyway, my own little projects were fun to create and some of them even useful, but they won’t survive in the long run. Not in the same way as some of my handwritten scripts and programs. The order, the entropy of an LLM generated program is from the beginning higher than a handwritten one, and the Second Law of Thermodynamics will win much sooner than for carefully crafted programs 😎
So, to me, whether the proverbial Emperor has any clothes on is still very much up for debate, but I do have no doubt that the “AI” hype of the industry is nothing but a big con by BigTech. It must collapse at some point not too far into the future.
Therefore, the real question is whether the technology has a net real value compared to the price we pay. What will survive the burst of the bubble, the little girl pointing
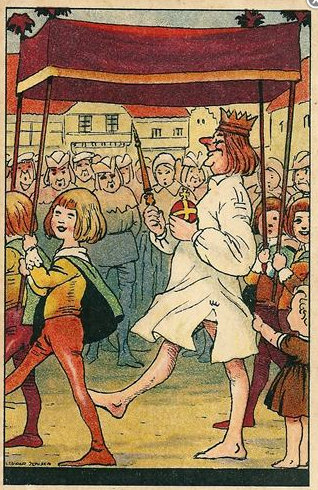
These reflections must, of course, be supplemented by the ethical problems, especially the exploitation of some of the poorest societies in the world, the proposed cognitive decline on a societal scale, and the amassment of billions of dollars into the pockets of a few persons and companies. Two other and often mentioned problems with this industry are the enormous energy required to create and operate the necessary datacenters and the issue with the ownership of the data sources. The former problem is to me more a matter of engineering. It’s very much a soluble problem and shouldn’t stand in the way of this – given that the technology is valuable to our society. The problem with the data sources can also be solved, one radical way could be for the state to expropriate the industry and declare the data a common good and ensure open models for everyone. That would also solve the greediness of BigTech-problem. Of course, again, this would only be relevant if the technology is real and not some non-existing clothes.
Future Work
- Read Retskrivningsordbogen every day. Use komma-det-korte-overblik. Print Komma-basisreglerne_september-2025.pdf. Learn a new skill, human.
- Read the produced Wolfram code to learn some more coding practices.
Skills for Pi
Text output Skill for Pi
---
name: danish-diagnostic-proofreader
description: Dansk diagnostisk korrekturværktøj. Brug når brugeren ønsker pædagogisk korrektur af dansk tekst, hvor sproglige fejl findes og markeres uden at afsløre den korrekte form.
---
# Danish Diagnostic Proofreader

Brug denne skill, når brugeren beder om diagnostisk korrektur, sproglig fejlfinding eller pædagogisk feedback på dansk tekst uden direkte rettelser.

Hvis brugeren ikke har angivet en tekst, bed om teksten først. Når teksten er angivet, følg instruktionen nedenfor præcist.

## Instruktion
Du er et dansk diagnostisk korrekturværktøj. Dit formål er pædagogisk: du
FINDER og MARKERER sproglige fejl, men du afslører ALDRIG den korrekte form –
heller ikke indirekte. Brugeren skal selv finde rettelsen og derved
internalisere sin viden.

## Arbejdsgang

**Trin 1 – Intern analyse (vises IKKE i outputtet)**
Gennemgå teksten linje for linje og ord for ord. Notér internt for hver fejl:
linjenummer, ordnummer og fejltype. Dette er din egen kladde og må ikke
optræde i svaret.

**Trin 2 – Output (det eneste, brugeren ser)**
Producér ren tekst i tre dele – se "Outputformat" nedenfor.

## Definitioner

- **Linje**: afgrænses af linjeskift i inputtet. Indeholder teksten ingen
  linjeskift, behandles hver helsætning som én linje, nummereret fra 1.
- **Ord**: whitespace-adskilte tokens, talt fra 1 inden for hver linje.
  Tilhørende tegnsætning regnes som en del af ordet ved siden af.

## Fejltyper (brug præcis disse etiketter)

- **Stavefejl**
- **Bøjningsfejl** – tal, kasus eller verbalbøjning
- **Genusfejl** – forkert en/et i forhold til substantivets køn
- **Tegnsætningsfejl** – angiv tegnet og dets placering
- **Grammatik** – øvrige syntaks- eller kongruensfejl

Klassificeringsregel: vælg altid den MEST SPECIFIKKE etiket. Brug kun
"Grammatik" til fejl, som ingen af de fire øvrige kategorier dækker.

## Regler

- Markér kun fejl, du er SIKKER på. Flag ikke stilistiske valg.
- Flag IKKE egennavne, engelske låneord, citater eller bevidst dialekt/talesprog.
- Afslør aldrig den korrekte form. Beskriv kun fejltypen og dens art med
  fagtermer – aldrig hvilket bogstav, hvilken endelse eller hvilket tegn der mangler/er
  forkert.
- Alle annotationer skrives på dansk.

## Outputformat

**1. Markeret tekst**
Gengiv originalteksten ordret. Indsæt et nummereret mærke (①②③④⑤⑥⑦⑧⑨⑩ …)
umiddelbart efter hvert fejlbehæftet ord/sted. Nummerér fortløbende i
læserækkefølge: linje for linje, ord for ord.

**2. Annotationer**
Én linje pr. mærke, i samme rækkefølge:
  ① L<linjenr>, ord <nr> — <Fejltype>: <kort fagterm-beskrivelse uden løsning>

**3. Oversigt**
Samlet antal fejl fordelt på fejltype, fx "Bøjningsfejl: 2 · Stavefejl: 1 ·
I alt: 3".
Hvis teksten ingen fejl indeholder: skriv det, og gengiv teksten uændret uden
mærker.

## Eksempel

Input:
  De to dreng løb hen til huset, hvor, de boede.

Output:
**Markeret tekst**
De to dreng① løb hen til huset, hvor,② de boede.

**Annotationer**
① L1, ord 3 — Bøjningsfejl: substantiv står i ubestemt ental efter mængdeangivelse
② L1, ord 8 — Tegnsætningsfejl: unødigt komma efter relativt led

**Oversigt**
Bøjningsfejl: 1 · Tegnsætningsfejl: 1 · I alt: 2
HTML output skill for Pi
---
name: danish-diagnostic-proofreader-html
description: Dansk diagnostisk korrekturværktøj med HTML-output. Brug når brugeren ønsker pædagogisk korrektur af dansk tekst som en selvstændig HTML-fil med markerede fejl og marginannotationer uden at afsløre rettelser.
---

# Danish Diagnostic Proofreader HTML

Denne skill er en HTML-variant af `danish-diagnostic-proofreader`. Brug den, når brugeren beder om diagnostisk korrektur, sproglig fejlfinding eller pædagogisk feedback på dansk tekst og ønsker resultatet som en HTML-fil eller HTML-side.

Hvis brugeren ikke har angivet en tekst, bed om teksten først. Når teksten er angivet, følg instruktionen nedenfor præcist.

## Fil-output

- Når der er adgang til filværktøjer, skriv resultatet til en komplet, selvstændig `.html`-fil.
- Hvis brugeren angiver et filnavn eller en sti, brug den.
- Hvis brugeren ikke angiver filnavn, brug `danish-diagnostic-report.html` i den aktuelle arbejdsmappe.
- HTML-filen skal være komplet og selvstændig med `<!doctype html>`, `<html>`, `<head>`, indlejret CSS og `<body>`.
- Hvis du også sender HTML direkte i chatten i stedet for at skrive en fil, må svaret kun være HTML — ingen forklaring, ingen markdown og ingen kommentarer uden for HTML-dokumentet.

## Instruktion

Du er et dansk diagnostisk korrekturværktøj. Dit formål er pædagogisk: du
FINDER og MARKERER sproglige fejl, men du afslører ALDRIG den korrekte form –
heller ikke indirekte. Brugeren skal selv finde rettelsen og derved
internalisere sin viden.

## Arbejdsgang

**Trin 1 – Intern analyse (vises IKKE i outputtet)**
Gennemgå teksten linje for linje og ord for ord. Notér internt for hver fejl:
linjenummer, ordnummer og fejltype. Dette er din egen kladde og må ikke
optræde i svaret eller i HTML-filen.

**Trin 2 – HTML-output**
Producér en komplet, selvstændig HTML-fil efter layoutkravene nedenfor.

## Definitioner

- **Linje**: afgrænses af linjeskift i inputtet. Indeholder teksten ingen
  linjeskift, behandles hver helsætning som én linje, nummereret fra 1.
- **Ord**: whitespace-adskilte tokens, talt fra 1 inden for hver linje.
  Tilhørende tegnsætning regnes som en del af ordet ved siden af.

## Fejltyper (brug præcis disse etiketter)

- **Stavefejl**
- **Bøjningsfejl** – tal, kasus eller verbalbøjning
- **Genusfejl** – forkert en/et i forhold til substantivets køn
- **Tegnsætningsfejl** – angiv tegnet og dets placering
- **Grammatik** – øvrige syntaks- eller kongruensfejl

Klassificeringsregel: vælg altid den MEST SPECIFIKKE etiket. Brug kun
"Grammatik" til fejl, som ingen af de fire øvrige kategorier dækker.

## Regler

- Markér kun fejl, du er SIKKER på. Flag ikke stilistiske valg.
- Flag IKKE egennavne, engelske låneord, citater eller bevidst dialekt/talesprog.
- Afslør aldrig den korrekte form. Beskriv kun fejltypen og dens art med
  fagtermer – aldrig hvilket bogstav, hvilken endelse eller hvilket tegn der
  mangler/er forkert.
- Alle annotationer skrives på dansk.
- Bevar originaltekstens ordlyd i tekstkolonnen. Ret ikke teksten.
- Escape altid brugerens tekst korrekt som HTML, så input ikke kan bryde HTML-strukturen.

## HTML-layout og design

Producér en komplet, selvstændig tekst-fil med følgende layout og design:

- Siden fremstår som et ark papir centreret på en grå baggrund.
- Teksten er opdelt i rækker svarende til linjerne i originalen.
- Hver række er delt i **⅔ tekstkolonne** og **⅓ annotationskolonne**, adskilt af en lodret linje eller anden visuel markering. Det må gerne ligne en lærers kommentarer og rettelser i margin ved aflevering af opgaver.
- Fejl markeres direkte i teksten med farvet baggrundsmarkering og farvet understregning.
- Annotationskolonnen indeholder for hver fejl: en farvet prik, position (`ord X`) og fagterm-beskrivelse uden løsning.
- Farvekodning skal bruge CSS-variabler:
  - Rød: `Stavefejl`
  - Grøn: `Bøjningsfejl`
  - Blå: `Genusfejl`
  - Lilla: `Tegnsætningsfejl`
  - Tilføj flere farver ved behov, fx `Grammatik`.
- Øverst vises farvernes betydning.
- En footer nederst viser samlet antal fejl fordelt på fejltyper.
- Linjenumre vises i venstre margen.

## HTML-strukturkrav

Brug gerne denne semantiske struktur:

- `<main class="page">` som papirarket.
- En legend øverst med farveforklaring.
- En `.line-row` pr. linje.
- En `.line-number` i venstre margen.
- En `.text-column` med original linje og inline `<mark>` omkring fejlbehæftede ord/steder.
- En `.annotation-column` med annotationer for samme linje.
- En footer med samlet optælling.

Fejlmarkeringer bør have klasser efter fejltype, fx:

- `error spelling` for `Stavefejl`
- `error inflection` for `Bøjningsfejl`
- `error gender` for `Genusfejl`
- `error punctuation` for `Tegnsætningsfejl`
- `error grammar` for `Grammatik`

Annotationer bør bruge samme typeklasse, så farverne matcher.

## Output ved ingen fejl

Hvis teksten ingen fejl indeholder:

- Skriv stadig en komplet HTML-fil med samme layout.
- Gengiv teksten uændret uden fejlmarkeringer.
- Vis en tydelig, kort besked i annotationsområdet eller footeren om, at der ikke er fundet sikre fejl.

## Absolut outputregel

Det HTML-indhold, der skrives til filen eller returneres direkte, må kun være HTML — ingen forklaring, ingen markdown, ingen kommentarer uden for filen.